国产8B模型现在这么强了么??
2017
- Waaaylon2026-08-21
商汤今天凌晨开源了SenseNova U1.5 Lite的正式版,说实话看了还挺震惊的,现在国产开源模型真的比想象中要好挺多,先给佬友们放链接:
GitHub:
github.com
GitHub - OpenSenseNova/SenseNova-U1: SenseNova-U series: Native Unified Paradigm with...
SenseNova-U series: Native Unified Paradigm with NEO-unify from the First Principles
Hugging Face:
huggingface.co
SenseNova-U1.5 - a sensenova Collection
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
SenseNova Studio,可以在线体验:
unify.light-ai.top
SenseNova Studio
TL;DR 这次主要更新了:
- 3-4k字符超长复杂指令遵循:能一次理解更长、更复杂的要求,同时处理主体、数量、位置、文字、布局和风格等多种约束,不容易漏细节。
- 更高质量的视觉生成:构图、色彩、材质、光影和细节更自然,整体完成度更高。
- 更可靠的原生图像编辑:改指定内容时更精准,同时更好地保持人物、结构、版式和其他区域不变。
- 更好的文字与复杂布局:中英文文字、海报、信息图和多文本排版更准确,也更擅长组织复杂画面。
- 更精细的视觉控制:支持框选、标记和多图参考等方式,更准确地指定“改哪里、改什么”。
- Native 4K高分辨率输出:直接生成4K高清图,同时保住构图、纹理、小字和光影等细节。
来看看Showcase:
先看图片编辑的例子,输入参考图片以及prompt:
沿用这张图的复古公益画报形式,做一张博物馆文物防潮保护信息图。
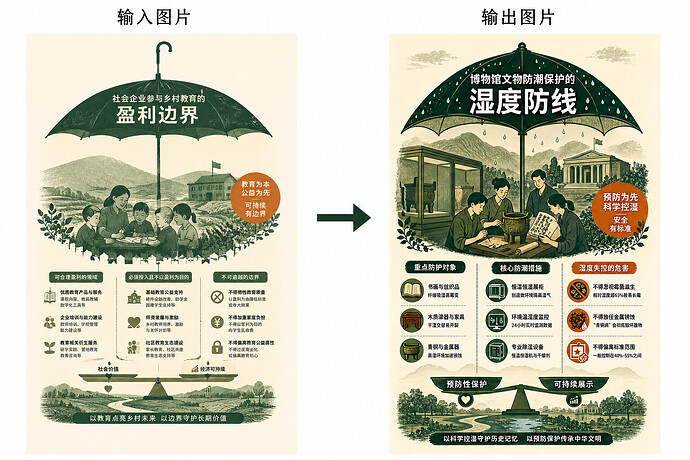
风格一致性保持的不错,而且会把海报里的元素做一下优化
除了图像编辑,还有多图像合成,可以把三张照片一起丢给它,让模型把三个图片里的元素融合到一起。
输入这三张图片:
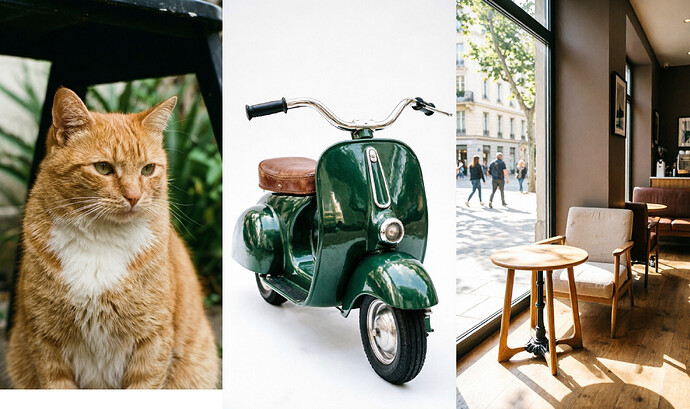
prompt是:
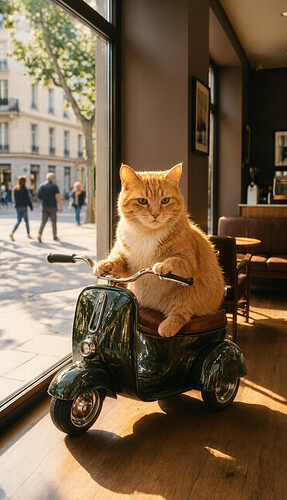
请将第一张图中的橘猫完美融合到第三张图咖啡馆落地窗边的场景中,并且让它坐在第二张图中的复古金属玩具车上。具体要求如下:
- 【角色与道具融合】:提取第一张图中橘猫的标志性面部特征(微胖的脸、绿色的眼睛)以及胸前那块倒三角形状的浓密白色毛发,使其姿态调整为骑在第二张图的金属玩具车上——橘猫的两只前爪需要搭在玩具车的电镀车把上,身体后半部稳稳坐在棕色皮革座椅上,猫咪的肉垫与金属车把、大腿毛发与车鞍边缘要产生自然的挤压、贴合与物理遮挡,绝对不能有生硬的贴纸感。
- 【空间透视调整】:将第二张图中原本为正面的玩具车,调整为符合第三张图地面透视的四分之三侧面角度,并等比例缩小放置在靠近玻璃窗的木地板上。
- 【物理光影与材质适配】:严格采用第三张图中斜向射入的金色午后阳光作为主光源。橘猫的背部、耳朵边缘和蓬松的毛发边缘必须被勾勒出一圈温暖闪耀的金色轮廓光(逆光效果);第二张图中的墨绿色金属烤漆车身、金属轮毂和电镀把手需要产生真实的日光高光反射,并映射出窗外的微弱街景;整辆玩具车(包含车上的橘猫)必须在右侧的木地板上投下符合光源方向、带有真实软边过渡的深色阴影。
然后就得到了一张哈吉米骑着小车在咖啡馆里的图片^-^
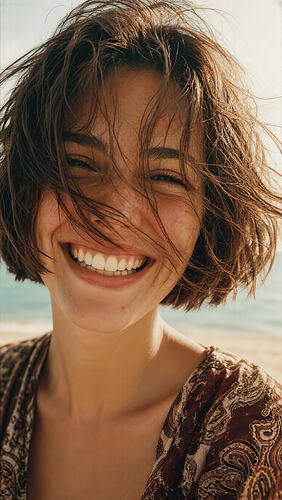
还有4K图片生成,现在噪点也少多了
还可以做到框选+标注的效果,相当于直接把prompt放进图里
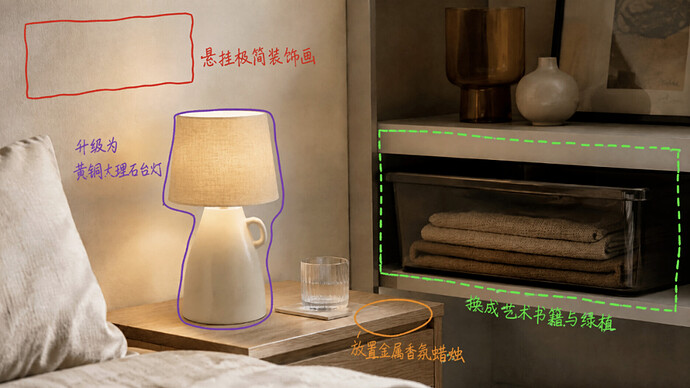
模型接到任务改完以后是这样:
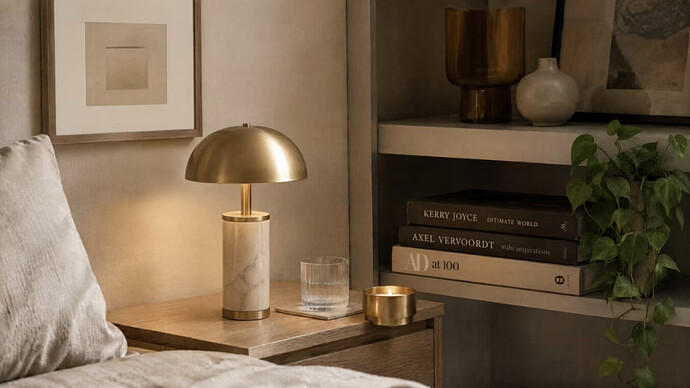
可以明显看到,几个目标区域都按照要求发生了变化,但床、床头柜、玻璃杯、右侧柜体,包括整个卧室原来的空间关系都基本保留下来
最后还有几个海报,也可以放上来,我很喜欢
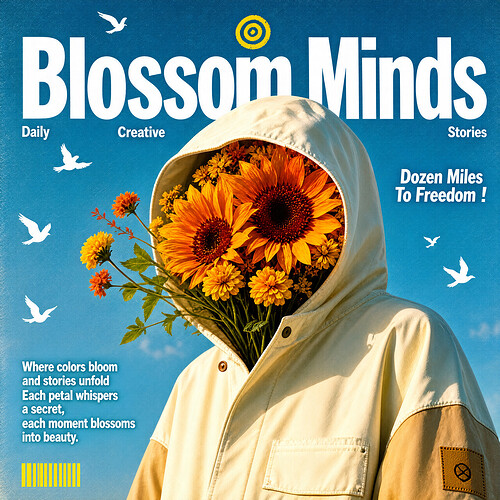
图片里面的各个元素的遮挡关系,排列的形式都比较舒服
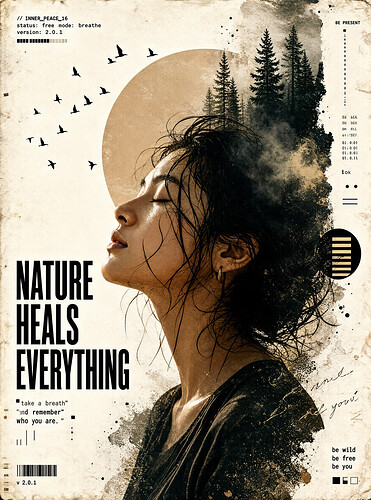
benchmark
最重要的是这个才8B参数,MoT模型,应该是能在垂直领域跟闭源模型掰一掰手腕的,这次就是:
U1.5 Lite在复杂排版与精准编辑等核心的场景上,已经能和闭源的GPT-Image-2比肩了
benchmark也验证了:
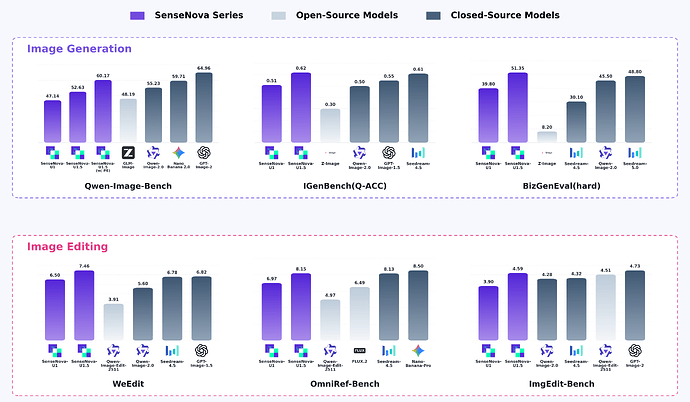
关于显存:
显存和速度这块前阵子刚优化过,原理大概是:MoT 结构,每层带理解和生成两套权重,但一次前向只用其中一套
之前的 offload 代码两套都搬,白白浪费一半带宽
改成只搬活跃分支之后:
模式 |
改前 |
改后 |full |
21.4s |
21.4s |balanced |
64.5s |
32.5s |low |
83.1s |
53.1s |(2048×2048、50 步、BF16、单卡 H100)
另外 token embedding 和 LM head 加起来 1.245B 参数在去噪循环里根本用不到,一起赶出去之后峰值显存 19.66 → 17.34 GiB。
改前改后输出 SHA256 完全一致,没有质量代价
注意这是 H100 的时间,4090或者5090这种消费级显卡跑不出这个秒数,但显存数字应该能对上
主楼 - HeriX2026-08-21
注意这是 H100 的时间,4090或者5090这种消费级显卡跑不出这个秒数,但显存数字应该能对上
图像模型也是一直在发展了
其实这半年出来的国产图形模型也挺多
z image
longcat image edit
jd image
Hidream等等
- 绿茶好呀,绿茶得喝2026-08-21
这效果不赖,看着很强了呀,这是默默的憋了个大的呀
- anhalpha2026-08-21
图像模型都这个体量,不然没法本地部署
- shock2026-08-21
8B 如果真有这个效果的确很强。
- waken2026-08-21
希望有些小参数的视频理解模型出来,现在视频理解模型都太大了
- shaiNpaa2026-08-21
这玩意放机器人里跑,一些基本的本地任务都能做了
- 不是多线程2026-08-21
它这原生统一多模态架构确实有点东西的
- Waaaylon2026-08-21
我也挺震惊的,而且他们更新速度还挺快,半个月更新一个小版本
- Waaaylon2026-08-21
是啊,这些国产模型在海外的关注度也挺高
- Waaaylon2026-08-21
视频模型还是费点劲,不过等等minimax H3以后出蒸馏版吧
- SDFshang2026-08-21
- 北邙2026-08-21
有佬友试过8G显存能跑吗?正在下载模型
- Waaaylon2026-08-21
8G可能不太够用,得24G以上,可以先用studio试试
- shock2026-08-21
多模态和纯文本模型不是一个量级 ^-^
- HeriX2026-08-21
只是8b的话 8g显存不是问题,毕竟8g显存都可以跑9b的flux2 klein了,量化一下
 GGbig2026-08-21
我看了下,还有gguf的版本,16g应该还是能跑下。
- Allyourneed2026-08-21
佬,哪里找到的这种case?看着就很难。