- 李大普2026-08-22
输入/缓存/输出 分别是 3/0.6/12
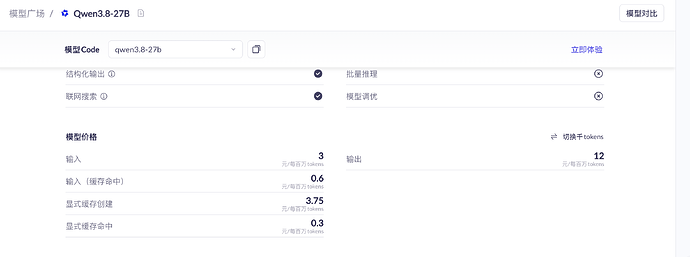
这更是比高峰时段的 v4 flash 还贵 ^-^
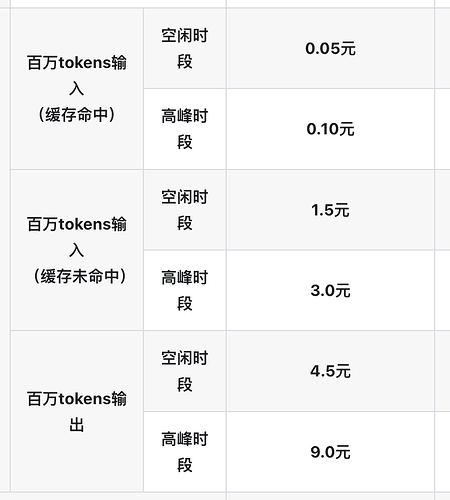 主楼
- Ruby2026-08-22
我在16g显存的显卡上自部署能跑160K上下文了,也勉强凑合用用了
- leisure2026-08-22
这么贵,还不如用DS的,效果更好点
- 咪叭2026-08-22
阿里是这样的,之前的qwen3.5 3.6也是这样,习惯了
- code2026-08-22
听一些佬友说稠密模型激活参数多,推理成本高
- 李大普2026-08-22
还真是,你说完我去看了一眼,3.6 27b版,甚至是3¥/18¥,还没缓存^-^
- cyclopentadiene2026-08-22
一方面设高价推大家做自部署能吸引用户群,另一方面如果不部署要用API,那就多收点也不亏 ^-^ 该租卡整uncensored了
- 海獭2026-08-22
阿里云的模型主打tob,tog,贵点很正常
- igg82026-08-22
大佬,怎么部署,能不能给一个大概的思路
- Ruby2026-08-22
unsloth那个ud-q3的13g量化,然后走llama.cpp的turboquant分支,k开tb4 v开tb3.上下文131072 显存占用15.4g 共用显存0.2g 都开tb3就可以160k了
- GloryDuck2026-08-22