- a74fcz5b2026-08-23
接上条帖子(开发了一个deepseek的指纹监控系统 )我做了一个deepseek的监控系统之后,我有想着接入点什么?
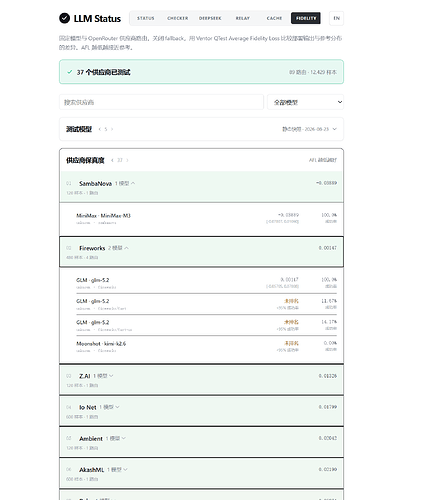
最近两天主要加了两个新功能,其中第一个是供应商精度排行榜,用的是腾讯朱雀实验室刚刚发的论文([2608.16391] Ventor-QTest: Threat-Model-Driven Verification of Vendor-Hosted LLM APIs )里面用的精度探针,然后让gpt5.6 sol vibe coding了一下,大概花了2,3块钱吧(网址为:大模型供应商保真度与精度损失排行榜 | LLM Status )。
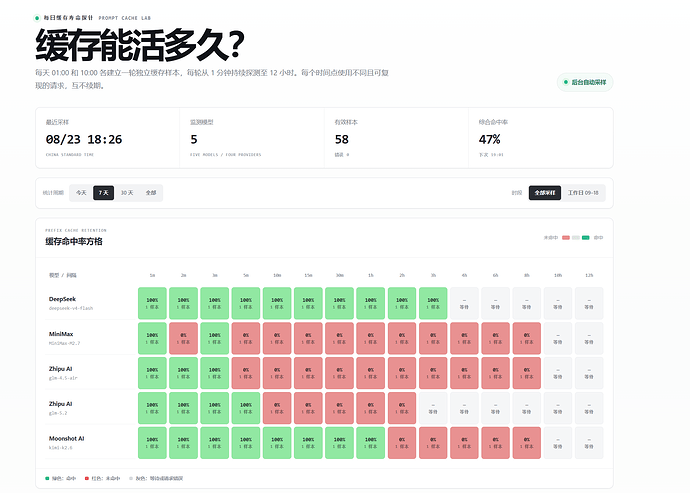
第二个功能就是接入了缓存命中时间排行榜,额,当然这里面的实现还有些问题,我还得再改改。
我目前是每隔1分钟,2分钟,3分钟,5分钟,以此类推,直到12h之后发起召回请求,然后再判断是否命中(网址为:大模型 API Prompt Cache 缓存有效期与命中率监测 | LLM Status )。
不过deepseek的实现好像有问题啊,我待会修修。
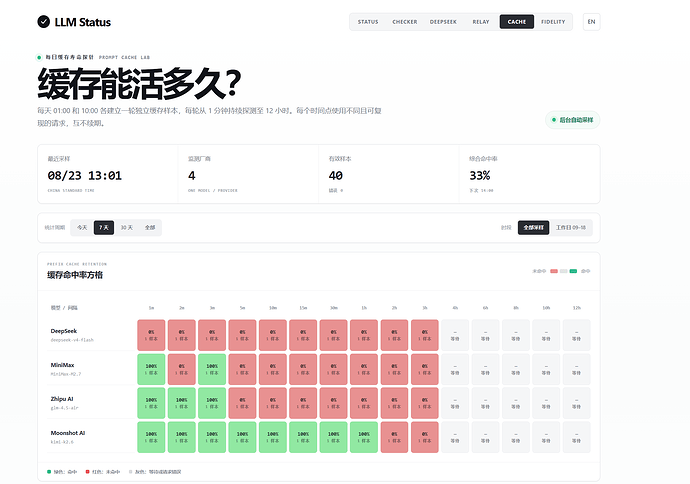
各位佬友看看还有没有想要我检测的指标?如果可以实现的话,火速帮大家vibe上去。
域名是(status compare ^-^ 我朋友说这就是赛博斗蛐蛐的域名)
LLM Status
大模型 API 服务状态 | LLM Status
聚合主流大模型 API 的官方状态、服务事件与 90 天可用率。
主楼 - pineapple2026-08-23
woc,牛逼了大佬,这是真有活…
- nuhou2026-08-23
大佬,网站呢,让我们体验一下吧。
- a74fcz5b2026-08-23
- HLiny2026-08-23
OpenRouter 自己不就有类似的数据吗?像缓存命中 90% 以上就没太大差别,不同用户的使用方法本来就不同
- a74fcz5b2026-08-23
有吧,我目前的cache只测试了官方的,而且这个cache率和缓存时长是正相关的,但是不能直接对应出来。还是可以提醒大家用zhipu的佬友没完成任务之前不要轻易去蹲坑。 ^-^
- 后皇嘉树2026-08-23
可能不同模型的缓存时间不一样,例如小模型反正不值钱,就不缓存了。智谱的 glm-5.2 缓存时间应该没有这么短^-^
- a74fcz5b2026-08-23
我新增一下glm-5.2试试看。
- a74fcz5b2026-08-23
- 后皇嘉树2026-08-23
我测的 glm5.2 缓存有一个小时,但是中间有小概率失效