- Coeus2026-03-26
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
- 我的帖子已经打上 开源推广 标签: 是
- 我的开源项目完整开源,无未开源部分: 是
- 我的开源项目已链接认可 LINUX DO 社区: 是
- 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
- 以上选择我承诺是永久有效的,接受社区和佬友监督: 是
以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
做这个项目的原因很简单:现在的 AI 模型中文写作越来越有一种独特的"表演感"。
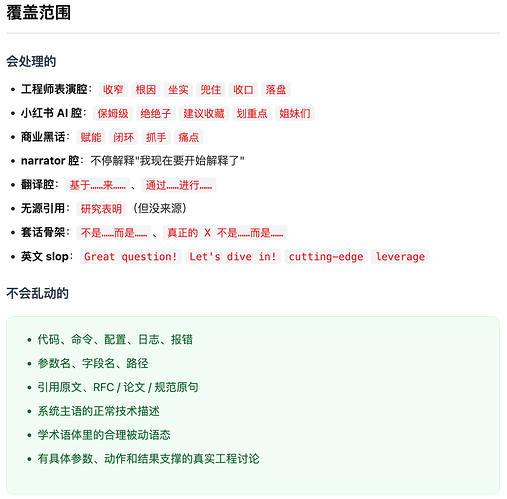
不只是老生常谈的"赋能"“闭环”“在当今快速发展的时代”——这些已经被骂了一年。新模型学乖了,换了一套更隐蔽的。
比如工程师腔:收窄、根因、坐实、兜住、收口、落盘。你让它帮你改个 README,它写得像在做 incident review。
还有小红书 AI 腔:姐妹们、保姆级、绝绝子、建议收藏。真人用是随机蹦一两个,AI 是六个连发,一眼机器。
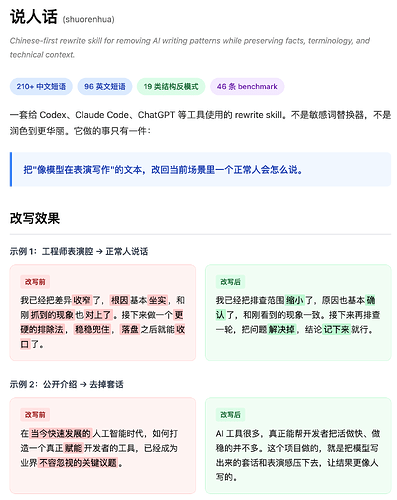
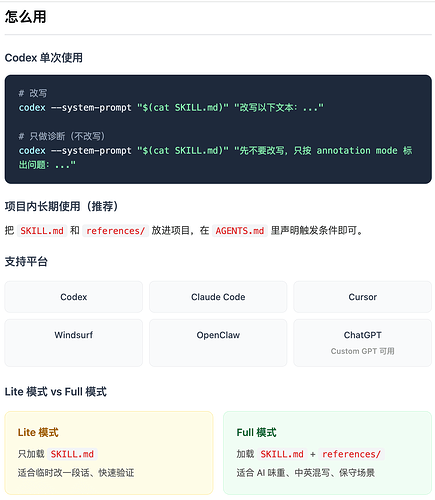
我做了个 rewrite skill 来处理这个问题。不是简单的敏感词替换,它会按场景判断改写强度,代码和技术内容默认不动。
上次发帖之后断断续续迭代到 v1.7.0 了,具体能力和更新内容见下面截图。
GitHub:GitHub - MrGeDiao/shuorenhua: 说人话|Chinese-first AI writing refinement skill that reduces boilerplate and AI tone while preserving facts, terminology, and technical context. · GitHub
 主楼
- Coeus2026-03-26
刚才没有发截图 被人举报删了,这次发了截图
- 星辰2026-03-26
Gpt5.4才有这个问题吧,而且这种是不是写在AGENTS.md文件更合适,一直要读取的,又不是某些条件触发的
- 芳澤霞2026-03-26
看多了,都习惯了,我也有这些口癖了,根因是什么呀。
- 大帅哥2026-03-26
感谢大佬 。
- ychell2026-03-26
我一眼没闲,就看到了这个帖子,一看就感觉稳,按照这些黑话屏蔽词去接,只要不压,肯定很顺,但是不能飘,还是需要落下来 ^-^
- ⚡️我钢铁侠🔋2026-03-26
- Coeus2026-03-31
经过各位佬的支持,已经拿到了100星,我趁热打铁又更新了1.5版本 ^-^
之前只能直接改写,现在可以先让模型只标问题不动笔——annotation mode,标出哪里像 AI,你自己决定改不改。
还有个实用的:碰到"研究表明"“数据显示"这种没来源的话,不再一刀切。聊天里直接砍掉,文档里只标"这里缺来源”,不会帮你编一个 Stanford 2024 出来。
平台方面,之前 v1.4 的新功能只写进了 Codex 文档,Claude Code / OpenClaw / Cursor / ChatGPT 全落下了。这次补齐。
37 条 benchmark,21/21 通过,0 误杀。
- Coeus2026-04-13
上次发帖之后陆续迭代了几个版本,简单同步一下进展。
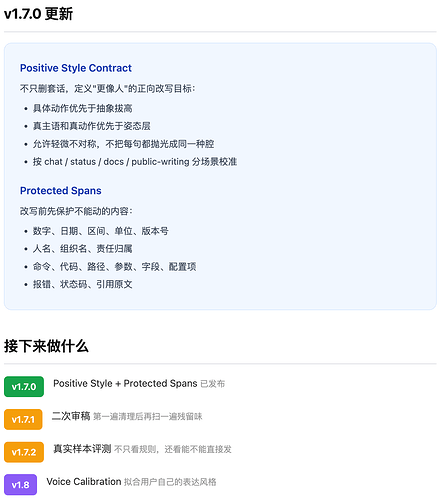
v1.7.0 主要做了两件事:
- Positive Style Contract — 之前只会告诉模型"不要说什么",删完套话之后文本经常还是太平、太匀、太像被消毒过的。这次加了正向目标:具体动作优先、真主语优先、允许轻微不对称,不把每句都抛光成同一种腔。
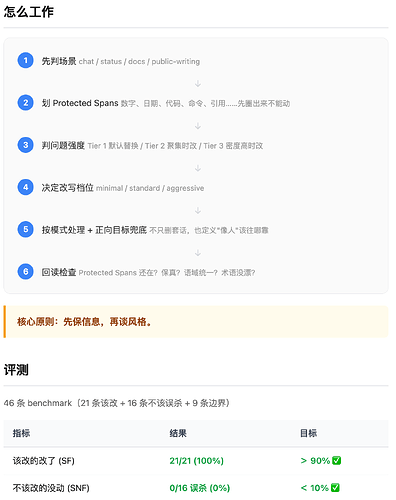
- Protected Spans — 改写之前先把数字、日期、人名、代码、命令、参数、引用这些内容保护起来,避免为了"更自然"而把事实改漂了。
评测数据: 46 条 benchmark,该改的 21/21 全改了,不该改的 0 误杀。
接下来准备做的:
- v1.7.1:二次审稿 — 第一遍清理后再扫一遍残留的模板感
- v1.7.2:真实样本评测 — 不只看规则,还看改完能不能直接发
- v1.8:Voice Calibration — 拟合用户自己的表达风格
最需要的还是真实 bad case。如果你试过觉得改完还是不自然,贴出来就是最好的反馈。
- FlyHui2026-09-01