- nanbloom0012026-09-01
我想部署一个本地小模型,我实验室有空闲 4*A10(Ampere架构 24GB),之前的是四卡部署 qwen3.8 27B W4A16,然后我优化了一下压缩到了 2 卡可用,在claude code 中也能有 100tok/s 左右的输出速度。现在多出了 2 张卡,想用一张卡来部署一下能用来聊天有人味的小模型。
最近星火出了 Spark X2.5 1.7B/4B 原生支持 1M 上下文,有点想尝试部署一下试试。
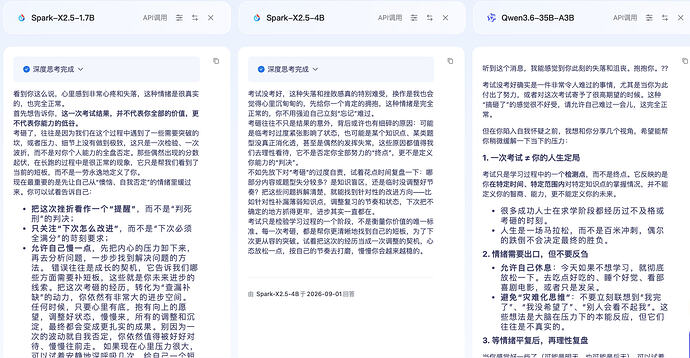
但是不知道本地单卡部署有什么比较好的有人味的模型,qwen3.8 感觉是编程特化过的,而且输出也不是很快,不是很适合用来聊天。
不知道这些模型怎么样:
Qwen3.5-9B
Gemma 4 12B
Ministral 3 14B
Granite 4.2-8B
MiniCPM5-1B
都是小模型,不知道好不好用,请问有没有佬友部署过相关的模型?
主楼 - superben2026-09-01
中文有点太博大精深了,
想把中文整出人味不太容易。
英语好可以考虑用英语,
直接把 AI 能输出的词库限制在常用单词里面占比在 80%。
出来的效果挺好的,
已经用上面的方案和国外甲方沟通很久了,
再也没有被老板或者同事批评说写出来的内容不好了。
- nanbloom0012026-09-01
顺便还可以锻炼英语阅读理解嘛?感觉英语的话 gpt 也能说的像人话 ^-^
- xxxsman2026-09-01
你反正有硬件,这几个模型也都不大,都拉下来跑了试试呗,试完后记得回来汇报,最好再加上 NSFW 内容的测试 ^-^
- superben2026-09-01
我是觉得还可以,
而且你可以把词库压得很小,
我现在是词库压到 1000 左右,
出来的句子基本上都是秒看懂。
就当玩纯英语游戏的生肉了,
后面可以慢慢把词库给他扩大了。
中文我就没办法了,
太博大精深了,没啥好思路。
- nanbloom0012026-09-01
这个工程量好大,我有一点技术强迫症,qwen3.8 27B 优化性能优化了两个星期,结果 vllm 都从 0.27.1 出到 0.28 了,又想去迁移一次了 ^-^
- xxxsman2026-09-01
你可以先别那么麻烦,LM Studio 直接下载 gguf,点几下鼠标的事,先跑起来聊几轮,粗筛之后留下两三个你觉得还行的,再详细调配置
另外,qwen3.5-9b 和 gemma4-e4b 我玩过,怎么说呢,纯聊天玩都还行吧,然后 gemma4 nsfw 胆子更加大一点点,记得去下载去审查版,RP 的话你要给它详细设定,不然会出戏聊不起来,但人格设定内容太多之后 prefill 又慢了,或者聊一会儿就开始不能专注,这没什么办法,小模型的通病
我现在玩自己设定的 RP 都不高兴搞本地小模型了,直接 OR 上 ds4f-0731 api,反正 ds 没道德感,纯娱乐随便瞎搞,注意峰谷计费的话一天也就大概 $0.05-0.15 左右吧
- nanbloom0012026-09-01
^-^ok 啊,感谢佬友回复,我打算先装一个 gemma 4 26B-A4B 和星火的 4B,一个是社区热度高,一个是支持 1M 上下文,我先尝尝咸淡
- 还是不懂2026-09-02
试试
gemma 4 31b→ 6bit刚出的时候测过,好像是酒馆唯一一个不掉格式的模型(qwen 3.6 122b我自己写的前端卡都掉格式的 ^-^