- Mozi2026-09-29
好久没有测试 Gemini 提取字幕的能力了,对 3.8 Flash 这个模型也进行测试
视频时长11分半,不对视频进行切片,一次性导入上下文,多模态分析
一次 API 调用完成字幕提取
测试一:音频转字幕
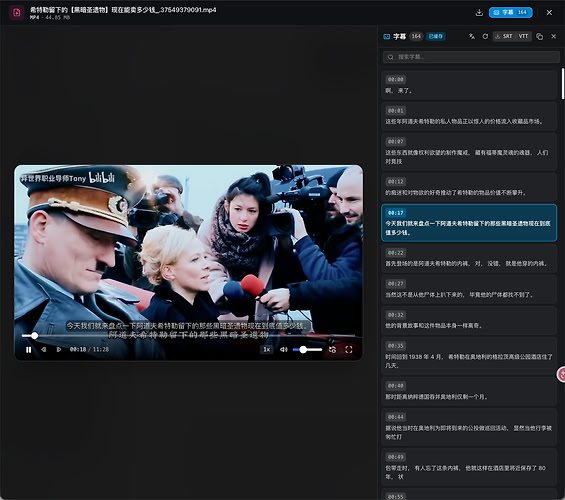
拖入音频文件,获取字幕
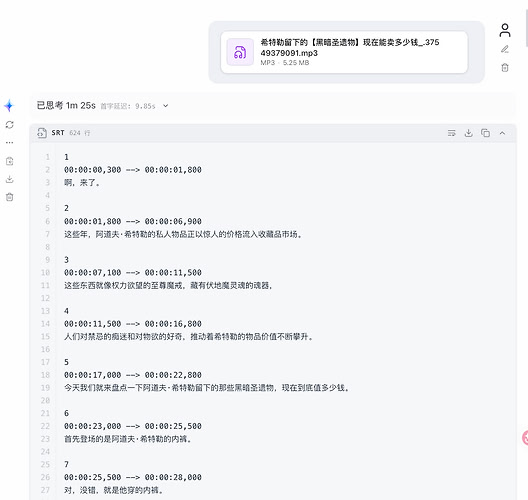
镜头这个位置是AI识别出的字幕
完成该操作时使用了17K的输入和8K的输出
只调用一次API
所有时间戳均准确无误
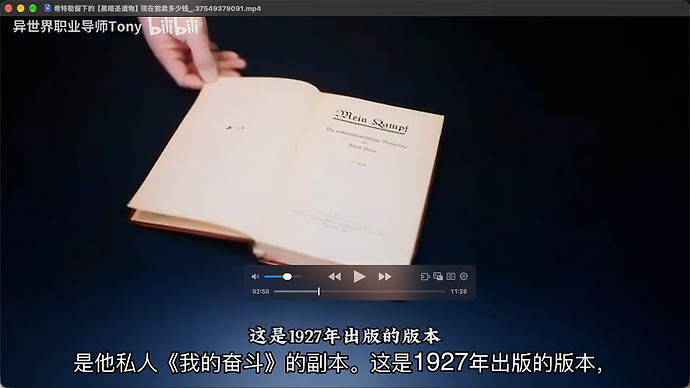
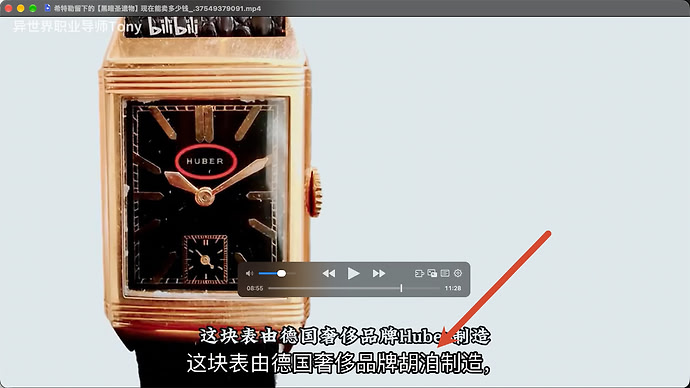
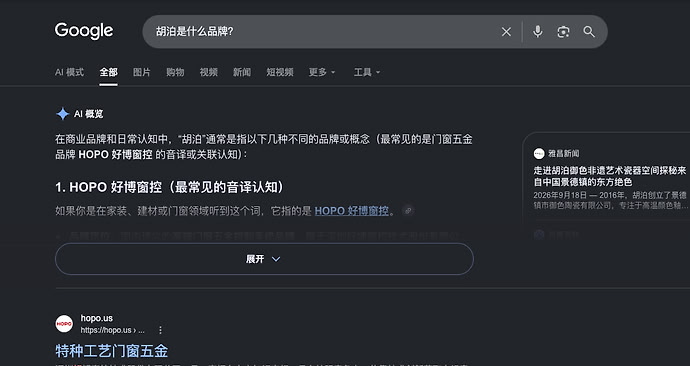
唯一缺点是该专有品牌采用了中文名称,这个中文名在互联网上均无法查询到
测试二:视频转字幕
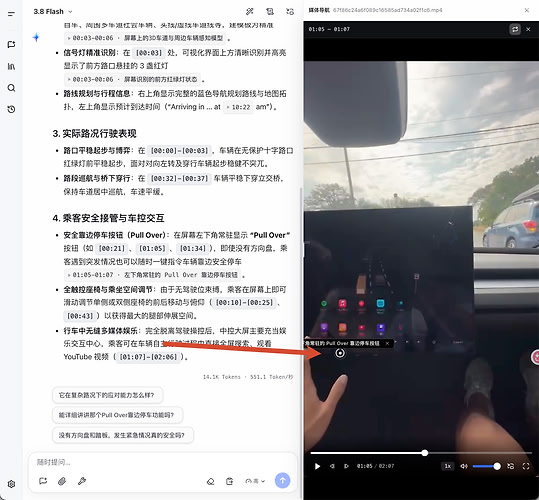
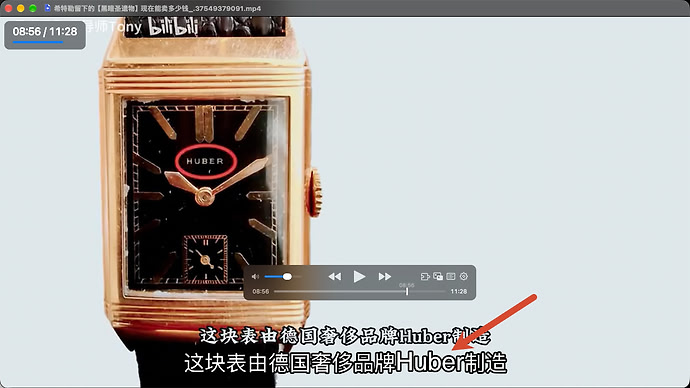
直接把视频文件拖入聊天框,可以通过视觉能力理解视频中的内容,这对字幕的提取更有帮助
时间戳依然准确,时间戳比视频内嵌的字幕更准
这就更加牛逼了,可以通过画面内容来进行修正
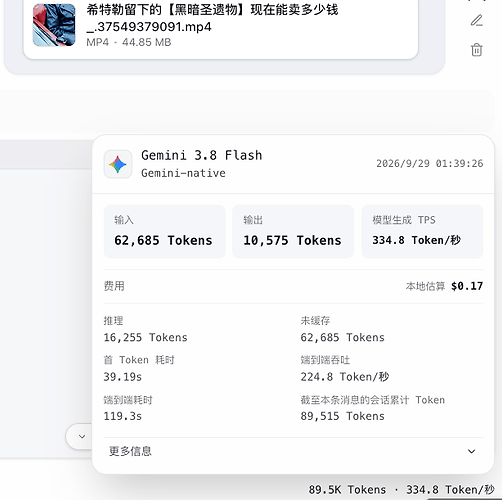
携带视频的情况下,Token 就需要多很多, 62K 输入,10K 输出
如果我是视频创作者,需要为视频添加字幕,那么 Gemini 就是我的唯一选择
靠多模态能力,AI 甚至可以一次性给出字幕,根据画面内容,针对性显示在画面的对应位置
主楼 - 美帝码工2026-09-29
其实 gemini 不是有一个专门的 Transcribe 模型吗?便宜一点。
- Mozi2026-09-29
- FizzBuzz2026-09-29
佬友,agy能用吗?agy上面没有专门的音频转写功能可选,在哪用呢
- Lisang2332026-09-29
agy的3.8flash也能用,效果也不错,我是CPA反代的,好像上传的文件大小有限制,我是用分片的方式做的。
- Mozi2026-09-29
用 AI Studio 的免费 API 就能使用,或者你直接在 AI Studio 里面聊天也可以
我的 Web UI 里面自带了这个提示词
- 黯绛2026-09-29
如果有硬字幕可以直接提取的,没必要给gemini吧 ^-^
- Mozi2026-09-29
- fablia2026-09-29
Gemini多模态强的一批,没有对手的
- Mozi2026-09-29
- 黯绛2026-09-29
- Mozi2026-09-29
- 黯绛2026-09-29
- Mozi2026-09-29
传统语音识别模型,我要实现高准确度的话,那我还是会选择千问云端的 Audio 3 ASR Flash
Gemini和这些传统模型根本不在一个层级,Gemini 是直接对整个上下文理解,加上画面理解
纯音频转字幕的话,传统语音识别部分情况会比Gemini优秀,但是视频转字幕,这就是降维打击了,那些模型只能输入语音,不能输入视频
- 黯绛2026-09-29
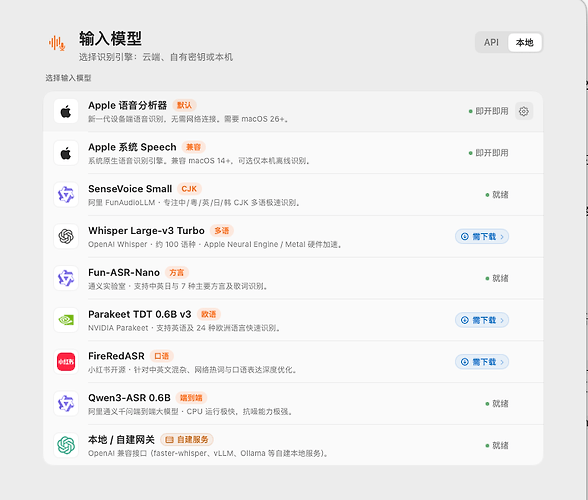
确实是,用起来很舒服,不过本地这些小模型我认为基本上能力都足够了还有剩下的。
特别是英文一个0.6B的模型就能通杀了。中文的特性在这要上个几B的也足够本地跑了。
视频转字幕要带图像理解Gemini是最好,但是时间和价格上如果没有免费pro的话我就觉得不划算了。
本地再让一个带视觉的模型去做更正可能效果也不错,毕竟gemma-12B带视觉层视觉理解足够这种场景,就是太麻烦了。
- RobinDai2026-09-29
- Mozi2026-09-29
- 黯绛2026-09-29
- 黯绛2026-09-29
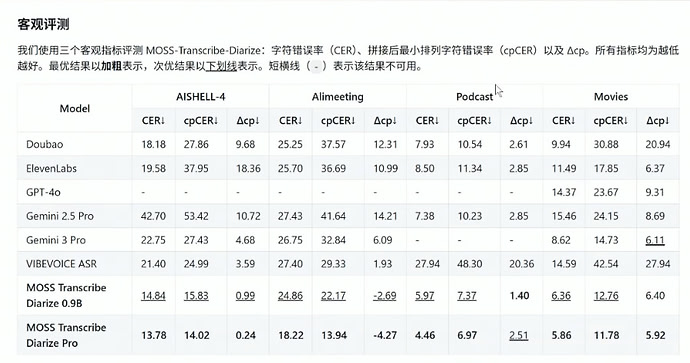
小红书的VAD效果最好,0.6Bv3英语能力可以达到准即刻出词的程度,moss-0.9b-asr中文最佳还有说话人划分也挺准。如果只是本地音频转选小红书的demo用就行。
原来不需要pro吗 ^-^