- 琴酒Gin2026-07-29
如题所示,目前手头上有两台实验室闲置的2xK80服务器,佬友们有没有什么推荐的模型可以部着玩玩且有用的?
因为之前的工作都是用的新核心框架的卡,能直接使用vllm部版本比较新的本地模型,现在换成这种老卡有点抓瞎了。
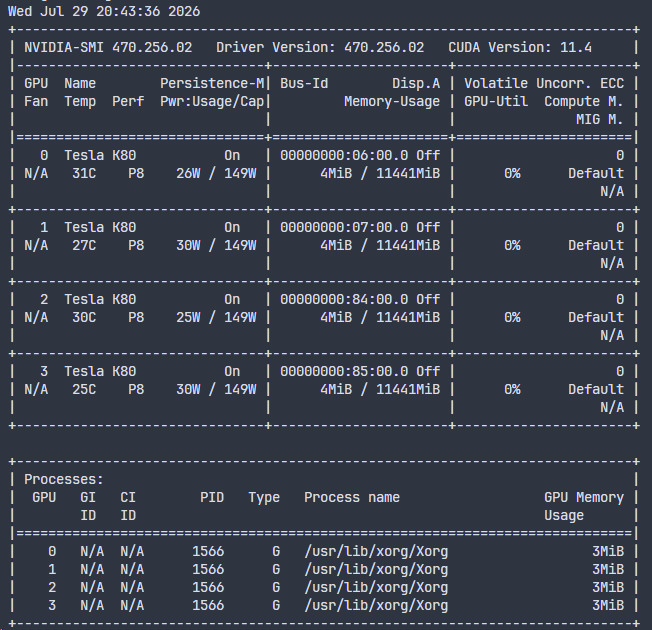
两台机器的配置都是图里这样的
 主楼
- Hughpig2026-07-29
- 琴酒Gin2026-07-29
对,就因为是老卡才头疼,这两个我跑实验部署过,实际体验效果感觉笨笨的,倒是可以再玩玩,谢谢佬的建议
- Autsun2026-07-29
llama.cpp部署量化版的qwen3.6 27B或者35BA3B,gemma4也可以考虑,不过不知道老卡能不能部署啊,可以试试
- 琴酒Gin2026-07-29
gemma4我比较感兴趣,前两者都体验过,不过倒是没试过走llama.cpp方式,当积攒经验了。谢谢佬
- Autsun2026-07-29
可以试试,自己编译一个,性能会好一点,可以让AI帮你编译
- acai2026-07-29
cuda11,不专门从源码编译推理框架,估计都跑不起来gpu吧
- Rosmonti2026-07-29
但挂ram+NvMe,但速度会相当感人
- 琴酒Gin2026-07-29
两台吃灰老古董了没法子,空着也是空着
- 冬马992026-07-29
可以部署几个OCR,比如说百度的、智谱的OCR都非常不错。只占用1GB显存,甚至更小。。然后部署一个3B的。阿里千问3.5模型用来识图也是非常不错的,当然要记得关闭。思考模式。
- mi_tu2026-07-29
跑个翻译用的小模型也挺好的配合沉浸式翻译
- 琴酒Gin2026-07-29
收到,ocr之前确实没想起来,可以一试,谢谢佬
- Hughpig2026-07-29
- lihua-linuxdo2026-07-29
这东西跟直接拿内存跑区别也不大吧
- 琴酒Gin2026-07-29
好的我试试,功率什么的倒不是问题